2026年8月19日、東北大学などの研究グループは、ナナフシのわずか数歩分の歩行データから、脚を協調させて歩くための原理をAIで学習し、その仕組みを六脚ロボットへ応用した研究成果を発表しました。
AIが学習したのは、正常なナナフシが平らな地面を歩く短いデータだけです。
それにもかかわらず、ナナフシを模したシミュレーションでは、凹凸地形に合わせて脚の動かし方を変化させました。さらに右中脚を使えない状態でも、残った脚が支持方法を変えて歩行を補いました。
研究グループはさらに、ナナフシから学んだ「報酬構造」を、体格も構造も異なる六脚ロボット「RedMirror」へ転用。ロボットの歩行学習を約3倍高速化し、実機でも協調した歩行を確認しました。
研究成果は2026年8月11日、科学誌『Bioinspiration & Biomimetics』に掲載されています。
今回の研究を簡単に整理すると
今回のポイントは、昆虫の脚の動きをそのままロボットにコピーしたわけではないことです。
ナナフシの歩行から、
「どのような状態なら、うまく歩けていると評価できるのか」
という基準をAIに学ばせ、それを別のロボットにも利用しました。
| 項目 | 今回の研究 |
|---|---|
| 学習元 | ナナフシ Medauroidea extradentata |
| データ量 | 約3〜4歩行周期・18関節 |
| 学習データ | 平地を直進する正常な歩行 |
| AIの手法 | 敵対的逆強化学習 |
| 検証 | 凹凸地形、右中脚を無効化 |
| 転用先 | 六脚ロボット「RedMirror」 |
| 学習量 | 約7万ステップ |
| 比較対象 | 単純な報酬では約20万ステップ |
| 実機 | RedMirrorで協調歩行を確認 |
研究に使われた教師データは、公開データセットに含まれるわずか約3〜4歩行周期分でした。
「逆強化学習」とは?
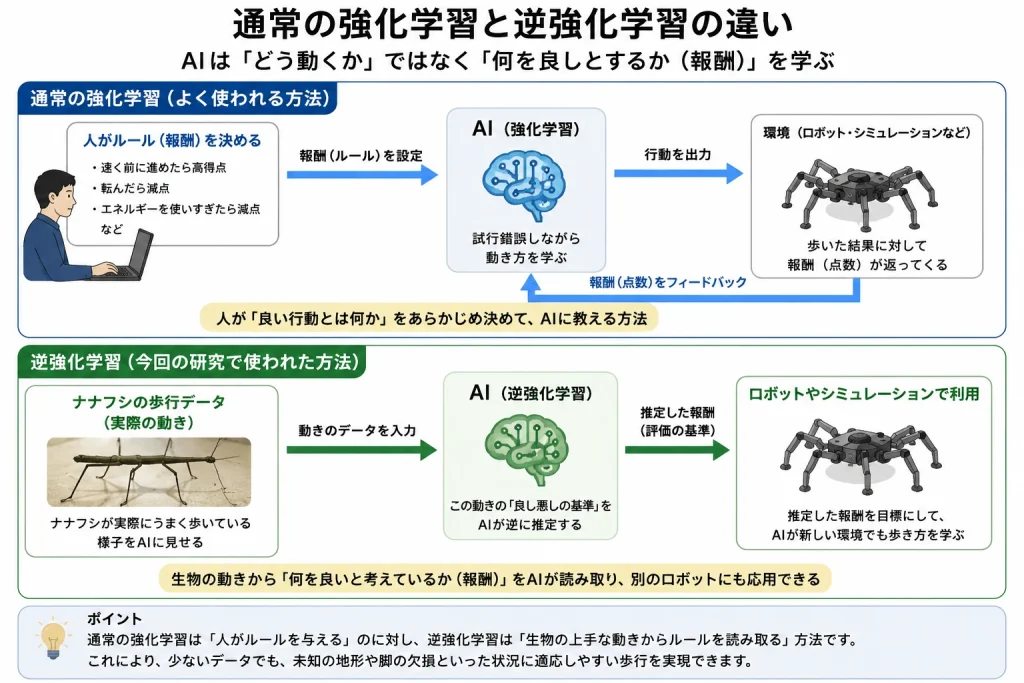
通常の強化学習では、人間があらかじめAIの「報酬」を決めます。
たとえば、
「前に進めば加点する」
「転倒したら減点する」
といった具合です。
AIは、この報酬ができるだけ大きくなるように試行錯誤しながら行動を学びます。
一方、逆強化学習では順序が逆になります。
すでに上手に行動している対象を観察して、
「この行動を生み出している報酬は何なのか」
をAIに推定させます。
今回なら、ナナフシの歩行データから「何を良い歩行としているのか」を学習させたわけです。
研究ではさらに「敵対的逆強化学習」という方法を使い、ナナフシの実際の動きとAIが作った動きを比較しながら、歩行を評価する報酬構造を抽出しました。
平地しか学んでいないのに、凹凸地形で歩き方が変わった
興味深いのは、教師データに凹凸地形での歩行が含まれていなかったことです。
AIが見たのは、正常なナナフシが平地を歩いているデータだけでした。
ところが、学習した制御を凹凸地形のシミュレーションで試すと、脚のタイミング関係が自律的に変化しました。
平地とは異なり、前脚から後脚へ波が伝わるように動かすなど、不整地に合わせた協調パターンが現れています。
つまり、
「でこぼこの場所では、この順番で脚を動かす」
というルールを人間が事前に設定したわけではありません。
平地の短い歩行から学んだ原理を使って、別の状況に対応したことになります。
脚を1本使えなくすると、残りの脚が補った
研究ではさらに、シミュレーション上で右中脚を無効化しました。
すると、残された脚が支持の仕方を組み替え、前脚や後脚が地面についている時間を増やすなど、失われた脚を補う動きが現れました。
ここでも、
「右中脚が壊れたら、この歩き方に切り替える」
という専用ルールを用意したわけではありません。
ただし、この脚欠損への適応はシミュレーション上で確認された結果です。
実際のロボットから脚を取り外し、故障状態で歩行させた実験ではありません。
この研究で本当に面白いところ
研究グループは、ナナフシ型モデルで学習した歩き方を、そのまま六脚ロボット「RedMirror」へ移そうとしました。
しかし、うまく歩けませんでした。
ナナフシとRedMirrorでは、体の大きさや関節配置、モーターの特性などが異なるからです。
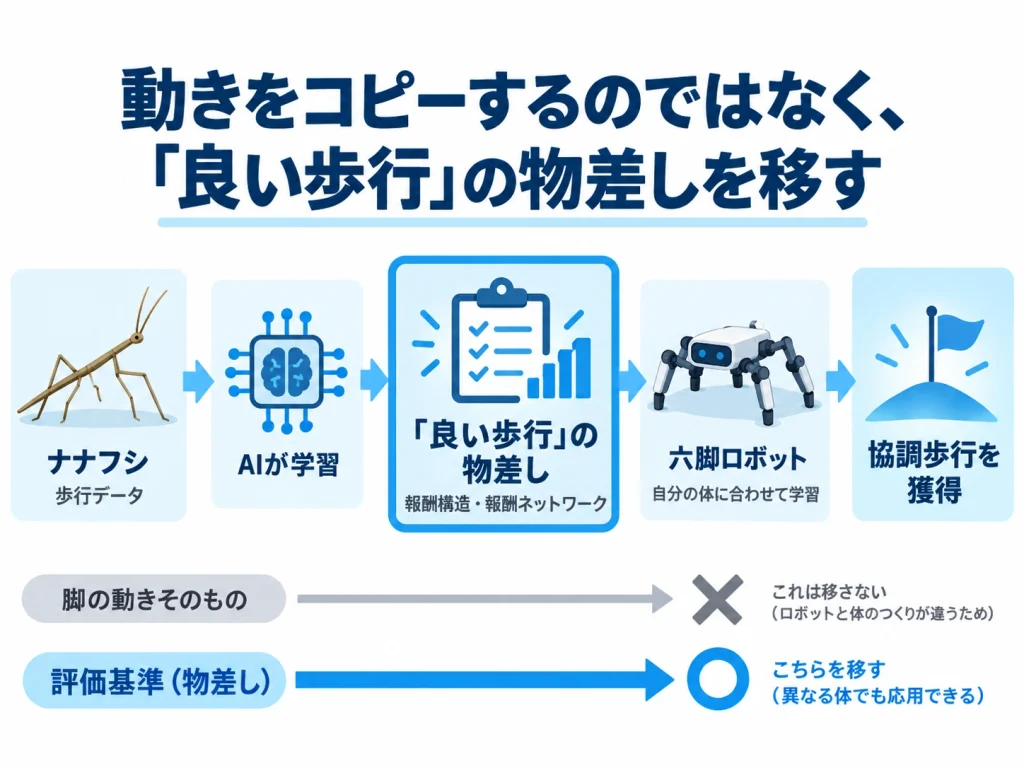
そこで研究グループは、歩き方そのものではなく、「何を良い歩行と評価するか」という報酬ネットワークだけを移しました。
そしてRedMirror自身に、自分の体に合った歩き方を学び直させました。
すると、六本の脚を協調させた歩行を獲得できました。
この研究の特徴を簡単に表すなら、
「正解の動き」を移したのではなく、「正解を探すための物差し」を移した
ということです。
ここが、単純な生物の動作コピーとは大きく違う点です。
学習量は約20万から約7万ステップへ
ナナフシから抽出した報酬ネットワークを使った場合、RedMirrorは約7万ステップ、約1時間8分で歩行を学習しました。
一方、従来型の単純な報酬だけを使った場合は、約20万ステップ、約4時間7分かかりました。
研究グループは、歩行学習が約3倍高速化したとしています。
さらに、単純な報酬でもロボットは前進したものの、脚の十分な協調や前後方向の区別を獲得できませんでした。
つまり今回の違いは、単に学習時間が短くなったことだけではありません。
「どんな歩き方を学習したか」にも違いがあったことになります。
実機の六脚ロボットでも歩行を確認
研究グループは、シミュレーションで学習した制御方法を実際のRedMirrorにも搭載しました。
シミュレーションと実機ではセンサーから得られる値などが異なるため、IMU(慣性計測装置)の信号を補正したうえで制御に利用しています。
その結果、実機でも六本の脚を協調させた歩行が確認されました。
ただし、今回の結果を「どんな環境でも歩けるロボットが完成した」と考えるのは早すぎます。
分かったことと、まだ分からないこと
今回の研究で確認された範囲を整理すると、次のようになります。
| 確認されたこと | まだ確認されていないこと |
|---|---|
| 少量のナナフシデータから報酬構造を学習 | 他の生物でも同様に使えるか |
| シミュレーションで凹凸地形に適応 | 実際の瓦礫でも同様に適応できるか |
| 脚1本を無効化すると残る脚が補った | 実機の故障にも対応できるか |
| 異なる六脚ロボットへ報酬構造を転用 | 二脚・四脚などにも転用できるか |
| 学習を約3倍高速化 | 他の機体でも同程度に高速化できるか |
| 実機で協調歩行を確認 | 複雑な実環境で長時間安定するか |
特に重要なのは、凹凸地形・脚欠損への適応と、実機ロボットでの歩行は別の検証だという点です。
凹凸地形と脚欠損への適応はシミュレーションで確認されました。
実機RedMirrorでは、シミュレーションで学習した制御を移し、協調歩行できることが確認されています。
そのため、
「脚が壊れた実機ロボットが瓦礫の上を歩いた」
という研究ではありません。
今後の課題は「記憶」
現在の制御には、過去の経験を蓄積して長期的に行動を変える「記憶」の仕組みが明示的には組み込まれていません。
研究グループは今後、記憶機能に加え、中枢パターン発生器(CPG)や反射といった生物の制御機構を組み合わせることで、さらに柔軟なロボット制御を目指すとしています。
将来的には、災害現場の探査やインフラ点検、惑星探査など、事前に環境を予測しにくい場所で活動するロボットへの応用が期待されています。
まとめ
今回の研究では、ナナフシの約3〜4歩行周期という短いデータから、AIが歩行の「報酬構造」を学習しました。
教師データは正常な平地歩行だけでしたが、シミュレーションでは凹凸地形や脚1本を使えない状態でも、脚の協調方法を変化させました。
さらに、ナナフシとは体の構造が異なる六脚ロボット「RedMirror」へ報酬構造を転用すると、歩行学習を約3倍高速化でき、実機でも協調歩行が確認されています。
今回のポイントは、ナナフシの動きをそのまま真似したことではありません。
「何を良い歩行と評価するか」という基準を生物から学び、それを別の体を持つロボットに利用したことです。
言い換えれば、生物からロボットへ移したのは「正解の動き」ではなく、**「正解を探すための物差し」**でした。
一方、凹凸地形や脚欠損への対応はシミュレーションでの結果です。実際の瓦礫や故障した実機で同じ適応能力を発揮できるかは、今後の検証が必要です。
今回の成果は「何でも歩けるロボットの完成」ではなく、未知の状況にも対応しやすいロボットを、生物のデータから学ばせる新しい方法を示した研究と見るのがよさそうです。
情報源・参考資料
- 東北大学「昆虫の『歩き方』をAIが解読しロボットへ ―数歩分のデータで六脚ロボットが適応歩行―」(2026年8月19日)
- Yuchen Wang et al., From insect behavior to transferable robot locomotion: inferring embodied locomotor principles from limited data via adversarial inverse reinforcement learning, Bioinspiration & Biomimetics(2026年)